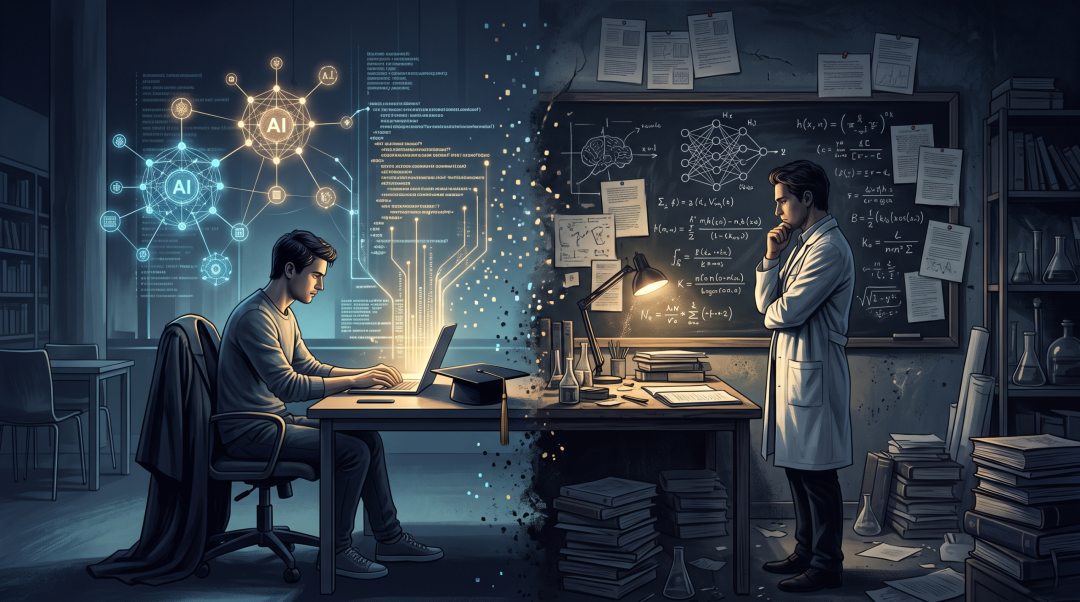
从“写作外包”到“思维外包”:美国22万STEM博士论文AI轨迹、学术去向与科研训练的根本重塑 基于NBER与Nature重磅研究的深度学理与职业去向分析
一、 导言:AI狂飙突进与科研教育的隐形拐点
自2022年底以ChatGPT为代表的大型语言模型(LLMs)问世以来,生成式人工智能(Generative AI)以前所未有的速度渗透至人类知识生产的最顶端领域——学术研究与高阶科研训练。在最初的震荡期,国际学术界与高等教育界的关注焦点大多集中于学术诚信争议、论文作弊识别以及期刊审稿政策的调整。然而,随着人工智能工具从早期的辅助拼写检查升级为能够直接生成完整学术段落、提炼复杂研究方法乃至构建学术论证的高阶认知助手,一个更为深刻且带有结构性重塑色彩的命题浮出水面:AI究竟是在帮助博士生提高科研效率,还是在无形中悄然替代原本属于人类学者独立思考与科学判断力的核心培养过程?
2026年10月16日,国际顶级科学期刊《Nature》发表了题为《PhD students who write dissertation with AI less likely to stay in academia》(使用人工智能撰写博士论文的博士毕业生留任学术界可能性更低)的重磅新闻与分析报道。该报道深度解读了一项来自美国国家经济研究局(NBER)的权威工作论文(Gross, Shvadron, & Zhang, NBER Working Paper 35859, 2026)。研究人员通过利用先进的AI文本检测工具(Pangram),对2019年1月至2026年5月期间在美国大学完成的超过22.6万篇科学、技术、工程与数学(STEM)领域的博士学位论文摘要进行了全景式大数据追踪与文本语义分析。
这项规模空前的实证研究展现出令人震撼的数据图景:在美国STEM博士论文摘要中,AI生成文本的检出率在短短三年内实现了从微乎其微到高频爆发的飞跃。然而,真正令学术界与教育政策制定者感到不寒而栗的,并非单纯的技术扩散速度,而是研究人员将这些博士生数据与其在领英(LinkedIn)等平台的职业履历连接后发现的深层规律:在论文摘要中检测出显著AI生成特征的博士毕业生,其毕业后进入企业界(Industry)工作的概率显著更高,而留任学术界(Academia)从事教学与基础科学研究的比例则呈明显的下降趋势。
这一发现绝不能被粗暴地简化为“使用AI的博士生水平差,因而被学术界淘汰”。正如研究者所强调的,这一现象触及了高等教育与科研训练最核心的本质命题:真正的科学写作(Scientific Writing)绝非仅仅是科研成果完成后的“语言包装”或“排版整理”,而是博士生在数年科研积累中将散乱数据升华为严密科学判断(Scientific Judgment)、训练批判性思维的核心认知环节。当博士生将最艰难的论文写作与逻辑构建“外包”给AI时,他们不仅跨越了语言障碍,也可能无意间跳过了成为一名成熟科学家所必需的思维锤炼过程。本文将全面梳理该项NBER研究的数据全貌、职业选择的分化机制、科学写作的认知本质以及非英语母语科研人员在AI时代的战略应对。
二、 数据洞察:三年间从1.7%到29.4%——AI对顶级学术训练的全面渗透
为了准确测量博士生在撰写学位论文时对生成式AI的依赖程度,NBER研究团队构建了一个包含2019年1月至2026年5月美国全境大学226,000余名STEM博士毕业论文摘要的庞大数据库。研究人员采用专为识别LLM文本特征打造的Pangram检测系统,对所有摘要进行了逐一筛查,并将其分类为“含有AI生成文本”与“无AI生成文本”。研究主导者、NBER经济学家Daniel Gross指出,在被检测系统判定为阳性的AI摘要中,高达90%的文本被评估为全篇完全由AI生成,这表明博士生并非仅仅利用AI调整个别词汇,而是大规模地将摘要段落直接交给AI撰写。
(一) 时间演进:指数级爆发的技术扩散曲线
数据清晰地记录了人工智能入侵学术顶峰的时间轨迹:在2023年之前,美国STEM博士论文摘要中的AI文本痕迹几乎为零。但在ChatGPT等大模型广泛普及的2023年,AI生成摘要的比例首次显现,达到1.7%。进入2025年,这一数字飙升至18.8%。而到了2026年的前5个月,在提交的博士论文摘要中,已被检测出包含AI生成内容的比例已高达29.4%——这意味着,在美国最新毕业的STEM博士中,每三个人中就有一人的论文摘要留下了清晰的人工智能印记。
| 年份/时间段 | AI摘要检出率 | 主要渗透学科/领域 | 核心驱动因素分析 |
| 2023年 | 1.7% | 计算机与数学领域率先尝试 | LLMs问世初期的早期使用者试探 |
| 2025年 | 18.8% | STEM各专业全面扩散 | 大模型API与写作辅助工具普及 |
| 2026年前5月 | 29.4% | 数学/计算机高达36% | AI工具深度融入日常科研与写作流程 |
| 非英语母语背景 | 41.0% | 国际博士生群体(美本以外) | 跨越英语语言摩擦与写作壁垒的刚需 |
(二) 学科差异与地缘背景的非均衡分布
1. 学科与项目梯队分化:研究进一步揭示,AI在博士论文中的渗透呈现出极其显著的学科与人口统计学不均衡性:
在数学与计算机科学(Mathematical and Computer Sciences)领域,博士论文摘要的AI使用率最为高企,高达约36%。由于该领域的博士生对算法与代码具有天然的亲和力,且日常工作紧密依赖代码生成与自动化工具,他们更倾向于将文本生成任务顺手交由大模型处理。此外,研究还观察到,在学术排名相对较低的博士项目(Lower-ranked PhD programs)中,AI生成文本的检出率显著高于顶尖名校的博士项目。
数据表明,在非英语国家接受本科教育的博士生群体中,约有41%的毕业论文摘要被检测出包含AI生成文本;相比之下,本科毕业于英语国家的博士生这一比例仅为23%。对于非英语母语(Non-native English speakers)的科研人员而言,用英文撰写语法严谨、文风地道的学术论文长期以来是一项巨大的额外认知负担。ChatGPT等工具的出现,极大地降低了这种“语言摩擦”(Language Friction),被许多国际留学生视为实现学术平权与提升表达效率的利器。
三、 归宿分化:用AI写论文的博士,为什么更少留在学术界?
如果说AI渗透率的飙升尚在情理之中,那么NBER研究最震撼学术界的结果,则是将论文AI使用特征与博士毕业后的职业轨迹(Career Pathways)进行的交叉匹配分析。研究团队通过LinkedIn等公开履历数据库追踪了这22.6万名博士生的去向,发现了极其鲜明的就业归宿分化。
(一) 关键统计数据与就业轨迹镜像
统计显著性关联:在本科接受美国教育的博士毕业生群体中:
其博士论文摘要被检测出AI生成文本的毕业生,毕业后留在学术界(Academia,包括担任 postdoc、助理教授或学术研究员)的可能性,比未使用AI的同类毕业生低了 17%(-17%)。
与此同时,这些使用AI写摘要的毕业生,进入产业界/企业(Industry,包括科技巨头、金融机构、医药研发企业等)工作的可能性,比未使用AI者高出 16%(+16%)。
值得注意的是,这种“AI使用与留在学术界负相关、与进入企业正相关”的强关联,在本科即在美国就读的本土博士生群体中最为剧烈;而在本科教育来自美国以外的国际博士生群体中,这种关联性则相对弱化。这一差异反向印证了国际学生使用AI更多是为了克服语言障碍,而本土学生使用AI则可能与更深层的职业选择偏好相关。
(二) 深度机制剖析:三大竞争性假说
面对这一惊人发现,我们应当如何理解“AI使用”与“学术去向”之间的内在因果机制?NBER研究团队与相关领域专家提出了三种交织在一起的解释框架:
假说一:认知与思维训练受损假说(Cognitive Erosion Hypothesis)。NBER联合作者Daniel Gross提出的核心忧虑在于,科学写作本质上是逻辑构思、假设验证与自我批判的过程。如果博士生在长达数年的博士训练中,习惯于将最需要动脑的科学论证构建、文献对话和结果解释“外包”给AI,可能会在无形中削弱其批判性思维、独立写作与深度科学推理能力。当这些学生面临学术界严苛的同行评议(Peer Review)、独立课题申请(Grant Proposal)和教职竞聘时,其科学素养的短板便会暴露无遗,从而在学术界竞争中处于劣势。
假说二:自我选择与理性激励假说(Self-Selection & Incentive Hypothesis)。另一种极具解释力的可能性是“逆向选择”。早已决定毕业后进入产业界的博士生,深知企业用人单位主要看重的是其代码能力、工程实施或实验技术,而绝不会像学术同行那样逐字逐句审视其博士论文的写作风格。因此,这些明确以企业为目标的博士生拥有更强烈的理性动机,通过AI将论文写作这一“学术履约成本”降至最低,以便腾出精力投递简历、准备面试。相反,立志留任学术界、渴望成为独立PI的学生,则不敢在毕业论文这一象征学术羽毛的仪式上掉以轻心。
假说三:学术市场结构变迁与经济现实假说(Academic Market Constraints)。悉尼科技大学学习科学学者Camille Dickson-Deane指出,博士生的职业去向受到学术界岗位极其匮乏、企业界薪酬待遇丰厚、高昂的生活成本以及学术界日益沉重的工作负担等多重现实结构性因素的强烈驱动。留任学术界早已不再像过去那样具有光鲜的吸引力。因此,AI的使用可能只是这一巨大职业流向变迁中的一个伴随性指标,而非直接因果源头。
四、 解构科研写作:为何写作不是“排版包装”,而是思考的精髓?
NBER的这项研究之所以在科学界引发巨浪,根本原因在于它撞击了当代科研教育中最容易被AI时代误解的一个核心问题:科研写作究竟是实验完成后的“排版整理工作”,还是科研训练本身不可分割的认知核心?
(一) 写作即思考:Discussion 撰写中的认知炼金术
在生成式AI盛行的今天,不少年轻科研人员陷入了一个危险的认知误区:以为科研就是“做实验、跑代码、出图表”,只要有了数据,后面的文本撰写不过是用漂亮的英文把事实填进去。既然AI可以在几秒钟内生成语法完美的英文段落,为什么还要花几个月时间苦苦折磨自己?
深层认知训练的必经之路:然而,任何经历过完整学术训练的科学家都知道,真正的科研写作从来不是语言工作,而是深刻的逻辑重构过程。以博士论文中最难写的“讨论”(Discussion)与“结论”(Conclusion)部分为例,一个博士生在撰写时,必须强迫自己的大脑回答一系列极其残酷的科学追问:
我的实验数据到底说明了什么?哪些结果验证了原有的理论假设,哪些异常数据与既有文献相左?为什么会产生这种偏离?
我的证据链条究竟能够支持多大的结论?哪些观察仅仅是统计学上的相关性(Correlation),哪些才真正具备严格的因果推论(Causal Interpretation)?
我的研究在整个学科演进史中处于什么位置?它与过去几十年里的上百篇经典文献形成了怎样的对话与互证关系?
研究中是否存在未控制的混杂变量?为什么某一个看似不起眼的对照组(Control Group)是必须保留的?
这些问题表面上是在“写”,实际上是在“重新理解自己的研究”。许多科研人员都有过切身体会:一个实验做了两三年,以为自己已经完全搞懂了,可一旦开始提笔写论文,才猛然发现逻辑链条中存在大量未曾察觉的漏洞。只有通过一次次艰难地修改提纲、推敲词句、重构段落,对研究本身的理解才能完成一次飞跃性的升华。科研写作,恰恰是人类大脑将散乱事实淬炼为严密科学知识的唯一途径。
(二) 悉尼新南威尔士大学 Ang Liu 的前沿探索困境视阈
悉尼新南威尔士大学(UNSW)工程学者 Ang Liu 在接受《Nature》采访时特别强调,生成式AI在处理既有知识(Known Knowledge)十分丰富的成熟领域时表现出色,可以迅速总结既有范式。然而,博士科研训练的本质,是要带领学生迈向人类知识边界的最前沿——去探索那些“答案尚未可知”的未至之境(Incomplete or Uncertain Knowledge)。
在大脑进入未知领地时,AI由于其基于概率预测的底层逻辑,极易给出平庸、套路化乃至幻觉性的推理。此时,如果没有经过极其严谨、近乎痛苦的传统科研写作训练,年轻学者就无法培养出对微弱科学信号的敏锐直觉(Scientific Intuition),也无法在面对矛盾数据时做出独立而精准的科学判断。
五、 驾驭抑或被驾驭:从“Use AI”到“Who Rules Whom”
如果把NBER研究与《Nature》的报道简单解读为“AI有害,科研人员应该全面禁用AI”,那就走向了另一个功利而狭隘的极端。事实上,这项研究本身向我们展示了一个极其微妙、甚至带有某种戏剧性黑色幽默的真实细节。
| 💡 经典案例:研究“AI外包”的学者自身如何使用AI?在这篇探讨“博士生是否把科学写作外包给AI”的NBER研究论文末尾,作者 Gross、Shvadron 与 Zhang 进行了非常明确且坦诚的学术披露:作者团队在撰写本篇论文时,同样使用了大语言模型 Claude 来辅助起草实证结果讨论(Discussion)的最初草稿以及部分数据附录(Data Appendix),但在此之后,作者团队对AI生成的内容进行了极其大量的密集人工修改、逻辑重构与事实核验。这一细节极其完美地诠释了AI时代的终极命题:关键从来不是‘使用AI’还是‘拒绝AI’,而是——‘谁在驾驭谁’? |
(一) 两种截然不同的AI使用模式
同样的“在论文写作中使用ChatGPT/Claude”,在不同认知层面的科研人员手中,代表着两种本质完全相反的模式:
模式一:放大科学家(Amplifying the Scientist)。研究者自身已经对研究问题、数据逻辑和推论边界有了极其清晰深刻的把握。此时,他将AI用作高效率的“文秘辅助”或“表达放大器”——帮助润色英文语法、优化段落衔接、检索相关文献、检查代码漏洞乃至寻找更地道的学术表达。在这种模式下,AI放大的是研究者原有的科学洞察力与生产力。
模式二:思维外包与跳过成长(Outsourcing Thinking)。博士生自身尚未形成明确的研究判断与逻辑链条,因为懒惰或焦虑,直接将 Introduction 的背景梳理、Results 的现象解释以及 Discussion 的科学论证全盘抛给AI。此时,AI替代掉的绝不仅仅是英语写作,而是本应由博士训练强行建立的独立思考与判断能力。学生看似提前两周交出了漂亮的论文,却永远错过了锤炼学术直觉的机会。
六、 非英语母语科研人员的战略突破:善用平权工具,守住专业护城河
NBER数据中“非英语母语背景博士生AI使用率高达41%”的发现,对于广大中国科研人员、医学专家及留学生群体而言,具有极其特殊的战略启示意义。
(一) 跨越“语言摩擦”,迎来历史性的语言平权
长期以来,中国及广大非英语国家的科研人员在国际顶级学术竞技场上面临着显著的结构性劣势:科学创新能力与英语写作表达能力被强行捆绑在一起。一个本土临床医生或生物学者,可能拥有极其扎实的临床经验与精妙的实验设计,但仅仅因为无法用精炼地道的英文撰写SCI论文,不得不耗费数月甚至数年时间在语言修改上反复折腾;而一个英语母语国家的博士后,可能只需一个下午就能写出流畅的段落。
这种“语言摩擦”(Language Friction)严重压制了非英语母语科研人员的创新产出。而生成式AI的出现,在人类历史上第一次从根本上平抑了这种语言壁垒。今天,通过合理使用AI工具进行文献检索、结构搭建、语言润色和审稿回复,中国科研人员可以将过去被语言内耗挤占的宝贵精力,重新释放到真正的科学探索之中。这是不可逆转的技术红利与“语言平权”。
(二) 守住不可被外包的“专业护城河”
然而,语言壁垒的消除并不意味着可以高枕无忧。相反,当语言表达不再成为门槛时,科研人员之间的竞争将迅速回归到科学洞察力本身。如果中国科研人员在拥抱AI的同时,顺手将核心的专业判断、假设构建与结果解释也外包出去,那么这种“语言平权”就会瞬间转化为“认知退化”。
重构人机协同的边界:未来的关键分水岭在于区分什么可以交给技术,什么必须留在自己的脑海中:
1. 果断外包:把文献格式整理、语法纠错、初级代码编写、数据格式转换等低认知附加值的重复性劳动,果断交给AI处理;
2. 牢牢锁死:提出前沿科学问题的能力(提出AI无法预测的问题);
识别数据偏见与AI答案隐蔽错误的能力(发觉AI在胡说八道);
跨学科合成全新科学断言的能力(将十篇散乱文献融会贯通);
对临床与实验伦理的终极责任感(决定什么结论值得坚信)。
七、 结论与免责声明
归根结底,归纳22万美国STEM博士论文AI痕迹的NBER研究以及《Nature》的深度报道,为AI时代的全球高等教育与科学研究敲响了警钟。技术的狂飙突进不可阻挡,未来的科研图景绝不是“用AI与不用AI”的简单对立,而是人类主体性与工具理性之间的深刻重构。
博士科研训练的终极目标,从来不是生产出一篇篇符合排版规范的文字印张,而是培养出能够在未知黑暗中独立思考、勇敢探索的科学家。那些在写作过程中经历的阻滞、痛苦的推敲以及对每一个异常数据的拷问,看似效率低下,却恰恰是在塑造一个学者最宝贵的资产——科学判断力(Scientific Judgment)。AI可以把一个成熟科学家的效能放大十倍,但如果年轻学者在尚未建立知识体系时就交出思考权,得到的也许是一篇精美的论文,却终究无法成长为一名真正的科学家。
| ⚖️ 免责声明 (Disclaimer):本报告及分析文章严格基于对公开学术文献(包括NBER Working Paper 35859及《Nature》期刊相关新闻报道)的客观学理整理与学术研讨。 文章中所展现的数据、案例及观点仅供高等教育研究、科研训练探讨及学术交流之用。 本报告内容不构成任何形式的商业投资建议、企业雇佣评估、职业规划承诺或法律与学术合规担保。 读者在参考本报告观点时,应结合自身具体科研领域与机构政策进行独立判断。 |